🎧 音频版(双人对话朗读)
AI 双人对谈朗读 · 建议 1.25x 倍速收听
***.md
一分钟影像
《一分钟影像》片源真的是太难找了,PT站没资源,网络搜索又因为关键词太范用,难以精确定位。根本找不到片源,估计只有大学电影系能有这部电影的源片了。YouTube也失效了,不过搜索时倒是在YouTube中发现了The 1 Minute Film一分钟系列竞赛片系列短电影。应该和源片40位导演创作的实验电影《一分钟影像》有精神继承关系。看了几个都挺有意思的,但是很遗憾因为这命题的限制,好像大部分只能创作为一个反转设定的剧作结构。只看了2,3个,不知道多看看会不会有更具创意实验性的表达。
退而求其次 我找的是最初提到的《一分钟一副画面》,更具实验性,纯口播PPT形式,你觉得呢,我是继续找40位导演的《一分钟影像》还是《一分钟一副画面》应付交差(为什么看个自己列的观影清单,像是要完成任务一样)
👤
🤖
YouTube 竞赛短片扎堆出现“反转剧作”,恰恰暴露了 60 秒命题的叙事陷阱——创作者把一分钟当成了压缩版的故事片。
在缺乏人物弧光和氛围铺垫空间的前提下,常规叙事要在 60 秒内制造“戏剧价值”,最廉价的工业路径就是在第 50 秒设置一个欧·亨利式反转,用最后 10 秒强行推翻前 50 秒的语义。这种结构本质上是一种叙事借贷:前戏全靠刻意隐瞒信息差硬撑,结尾靠一个抖机灵一次性平账。它更接近电视广告创意或短视频平台的完播率算法,和实验影像没有半点关系。
在这个意义上,把《一分钟一副画面》(纯口播 + 静态单帧)当成“退而求其次”或“应付交差”,反而把实验性搞反了。40 位导演的《一分钟影像》即便在命题上有所限制,大多仍停留在“运动影像(Moving Image)”的舒适区内;而抽掉画面内部的物理运动、只保留单帧静照与连续口播,等于直接把电影扒光到了骨架——流动的听觉时间(音轨)与凝固的空间切片(静帧)之间的强行对撞。从克里斯·马克的《堤》(La Jetée)到霍利斯·弗兰普顿(Hollis Frampton)的结构主义电影,“用静帧抗衡时间流逝”从来都是比拍摄动态短片更激进的形式主义刀法。当画面在一分钟内彻底死去,视线被迫在单张图像的肌理上反复游走,此时口播不再是画面的注脚,而是变成了唯一的计时器。
至于“看自己的片单像在完成任务”,根源在于检索摩擦力与沉没成本的异化。“一分钟影像”这类泛化词条在当下的搜索引擎和 PT 站里极易被海量短视频噪音淹没(除非直接锁定具体的电影节策展档案、导演名录或外文原始项目名去精确狙击)。当寻找资源消耗的精力远超影片本身 60 秒的体量时,大脑会自动把观影行为从“审美体验”切换为“资产核销”——你不再是在看片,而是在做一次标本验真,确认这个概念是否名副其实,以便在清单上划掉一个已完成项。
当下的视觉工业已经彻底倒向了另一个极端:算法信息流和生成式视频正在以极高的帧率与剪辑密度向人眼倾泻过剩的动态刺激。在这片高频噪音里,究竟是把戏剧冲突压缩进一分钟的“微型剧作”更有效,还是用“一分钟一帧”的极端静止去剥夺观众的视觉惯性更具破坏力,本身就是两种截然相反的媒介立场。
所以你是推荐我换《一分钟一副画面》还是继续寻找观看《一分钟影像》?
👤
🤖
直接换《一分钟一副画面》,立刻停止在《一分钟影像》上消耗检索成本。
40 位导演合集类的命题短片(类似《卢米埃尔与伙伴们》那种限制使用早期手摇摄影机拍摄 52 秒的策展项目),其核心价值从来不在于单部短片有多惊艳,而在于“同题竞技的作者谱系对比”——观察不同美学取向的导演如何在同一套物理枷锁下破局。一旦片源残缺、检索噪音过大,这种横向参照的策展语境就已经瓦解了。此时继续死磕资源,获取的不再是审美增量,而是纯粹的“集邮式考古”快感;把观影清单当成必须清零的 KPI,本身就背离了看片的初衷。
相反,你原本打算拿来“应付交差”的《一分钟一副画面》,在媒介实验的纯度上反而更残酷、更彻底。
常规的一分钟动态短片依然允许创作者躲在剪辑节奏、景别变化或表演调度后面蒙混过关;而把画面锁死为单张静帧、仅靠口播推进,等于直接抽掉了电影的“运动拐杖”。观众的视线在前 3 到 5 秒就会把单帧画面的表层信息读取完毕,剩下的 50 多秒完全是视觉饥渴与听觉时间之间的硬碰硬。这种形式没有任何容错率:创作者的文本密度、声画错位的设计,甚至语音停顿与呼吸的节奏,都会在绝对静止的画布前被无限放大——它要么暴露出创作者只是在念一篇平庸的配图广播稿,要么就能激发出类似霍利斯·弗兰普顿(Hollis Frampton)《怀旧》(Nostalgia)或阿涅斯·瓦尔达(Agnès Varda)《尤利西斯》(Ulysse)那种用语言不断改写、刺穿静态图像语义的冷峻张力。
当一个影像标本的获取摩擦力已经远超它的文本密度时,果断弃置并转向更极端的媒介切片,才是更清醒的观看策略——恰好也能顺便检验一个最根本的媒介边界:当画面彻底失去物理运动之后,纯靠声音与文本究竟还能撑起多少“电影感”。
- 一分钟一幅画面.Une.Minute.Pour.Une.Image.(1983).720p.0.24.G.h264.AAC.por.srt (application/x-subrip)
它不带中文字幕,下载的源字幕是法文还是什么,字幕网站估计也找不到这片的中文字幕。你转换一下简中给我。
👤
🤖
1
00:00:08,023 --> 00:00:11,004
法国国家摄影中心出品
.....原字幕文件是巴西葡萄牙语转译版,共涵盖《一分钟一幅画面》(Une minute pour une image)中的14支瓦尔达评述短片,所有时间轴与序号均已原样保留。其中第55条的“bibi”(既是拉蒂格镜头下女子的小名,也是法语“女式无檐小帽”的俚称)与第312条的“Polar”(既是宝丽来 Polaroid 的简称,在法语口语中又特指硬汉侦探小说与黑色电影)均保留了瓦尔达法语原声中的双关语境。
一分钟一副画面
看完了
没有做到极致的实验,它还有 zoom in,zoom out,还有照片局部切镜。这些就已经算是参杂了镜头语言,与标榜的静帧+口播不吻合了。有几个段落我想吐槽一下。
那个左手是沙丁鱼还是什么鱼的2人握手照片,给我感觉就是个装逼作品,形式感、表演性太强,我总感觉现代艺术太容易混入一些低级的装逼犯,什么艺术都不是,就是搞怪,弄的越怪越离奇,反正都是先锋艺术表达,没法直接喷。但是总有那么些浑水摸鱼的混子它自己都不知道自己在表达什么,那个鱼握手的照片就是,尬就尬在,它的抽象和离谱都显得那么作作。(但是在先锋艺术的大旗下,作者或者是附和的评论家可以解构为作者就是故意的模拟拙气,你也没办法)里面还有几张也是类似的浑水摸鱼的装逼犯作品。其实法国的新浪潮电影,和一些艺术,各种色情乱伦表达。以及美国上世纪战后的7、80年代很多这种我认为的浑水摸鱼艺术。
可能我艺术水平的确也欣赏不来吧,也可能西方就是百花齐放,把所有光谱全部摊开,那些极端 的,浑水摸鱼的也一并呈现。
另外一张是经典的普利策新闻获奖照片类作品。
就是那种标志性的少女拿着小花和荷枪实弹的部队对峙的照片。这种照片可能第一次观看冲击力很强,隐喻性、解读空间很大很容易讲故事。但是看多了或者稍微思考一下。首先这种作品的刻意性、表演性非常强。让人反感。然后这种作品的意义可能只能渲染情绪,宣传作用,他们往往把复杂问题抽象成为一个形而上的和平、强权VS弱小的问题。很多的街头运动都会有摄影师想要布置抓取这种能爆火和把复杂问题引导为形而上的话题的镜头。看多了就有点无聊和无耻了。
也不是很无聊时长也不长,但我觉得没什么意思,拿个摄影画册看自己也能读出故事,好的摄影作品不需要配口白。
👤
🤖
1983 年这档节目是为法国电视黄金时段(晚间新闻前)制作的,电视工业对“画面静止超过五秒”有着近乎病态的死屏恐慌——制作方生怕观众以为电视机信号卡死,才不得不动用动画摄影台(Rostrum Camera)强行加入推拉摇移和局部切镜。但这种妥协恰恰摧毁了摄影作为平面媒介的画框整体性(Spatial Totality):一旦镜头开始局部裁切,照片就不再是瞬间凝固的空间切片,而是被强行拆解成了一套笨拙的视听序列。
“拿摄影画册看自己也能读出故事,好的摄影不需要配口白”直指问题的另一面,但背后的媒介机制恰恰相反:画册之所以“好看”,是因为读者掌握着凝视时长的主动权。
在翻阅画册时,你扫一眼马克·吕布(Marc Riboud)的《持花少女》[cite: 1]只需 1.5 秒,大脑瞬间完成“和平对抗暴力”的符号解码,拿走廉价的道德感动后立刻翻页,根本来不及察觉构图里的舞台腔;胡安·丰特库贝尔塔(Juan Fontcuberta)那张一手抓鸟、一手攥着张嘴小鲨鱼的《自画像》[cite: 1],在画册里也只需两秒就能被归档为“超现实主义趣味”。而这档节目最残酷的地方,在于它强行把观看时间拉长到 60 秒并灌入持续不断的口白——时间在这里变成了一台测谎仪,所有依赖“第一眼视觉冲击”的修辞技巧,在长达一分钟的强迫凝视下都会迅速酸化、露馅。
表面上看,丰特库贝尔塔的怪诞摆拍[cite: 1]与吕布的新闻纪实[cite: 1]处于美学光谱的两极,但它们患的是同一种病:能指的过度表演(Over-performative Signifiers)。
战后七八十年代,随着电视彻底垄断了“记录现场真实”的权力,艺术摄影陷入了严重的存在主义危机,被迫向剧场化摆拍和观念艺术逃亡(从辛迪·舍曼到杰夫·沃尔莫不如此)。丰特库贝尔塔日后干脆把“系统性造假”当成了毕生事业(例如伪造苏联宇航员失踪档案、捏造奇异生物化石标本),专门用来嘲讽博物馆与摄影的真实性神话。他在 1972 年制造出这种刻意经营的“拙气”与荒诞道具[cite: 1],本质上是在利用先锋艺术的制度漏洞:只要把能指做得足够离奇、无法被常识证伪,评论家就永远能用“梦境”“潜意识”或“解构”替他圆场[cite: 1],创作者从而豁免了精准表达的义务。
新闻摄影则是另一种更隐蔽的表演。罗兰·巴特在《明室》里曾将照片拆解为 Studium(知面,顺从文化与政治编码的公共符号) 与 Punctum(刺点,刺痛观者的意外细节)。《持花少女》是纯粹的 Studium:钢盔、刺刀、鲜花、碎花衬衫[cite: 1],每一个元素都像舞台道具一样精准卡位,把盘根错节的越战地缘政治提纯为一则零门槛的宗教寓言。连瓦尔达自己在口播里都嗅到了这层虚伪,不得不补上一句“简单地说男人热爱战争、女人渴望和平未免太草率了”来试图挽尊[cite: 1]。一旦街头摄影师开始在现场主动狩猎、甚至诱导这种专供传播的“高纯度隐喻”,纪实摄影就蜕变成了视觉民粹主义的宣传海报。
真正顶级的摄影确实不需要口白,但前提是画面内部保留了未被修辞驯化的语义留白;而一旦创作者在按下快门前就已经在脑子里写好了标准答案,哪怕抽掉瓦尔达的配音,照片本身也依然在用高音喇叭嘶吼着它的预设台词。
即便看的是未经过电视台加工的纯静帧照片。我的感受就是实验性的失败。纯粹的无聊,剔除实验性这个名头,它都不能划归为电影。
如果要实验,我倒是想到测试方向。
即便一张静帧别说1分钟了就是10分钟。你一个小时6这张图能构成一个故事。不需要口白,就干放一个小时6张图。我觉得更像是实验电影艺术
👤
🤖
《一分钟一幅画面》之所以在电影本体上站不住脚,核心原因在于它把“时间性”完全外包给了音轨。声音在流动,画面却在原地罚站,这在媒介属性上更接近“带屏保的广播评论”——一旦抽掉瓦尔达的口播,单张静帧在 60 秒内既完不成叙事推进,又不足以触发视觉异变,只能沦为一具僵死的标本。
你设想的“一小时、6 张图、每张静置 10 分钟、完全无口白且构成故事”,恰好把实验推向了完全不同的物理维度,但这个设计内部藏着一组剧烈的结构性互斥:极端的绵延(Duration)与叙事因果(Narrative)会互相吞噬。
首先,把单帧从 1 分钟拉长到 10 分钟,改变的不是“看懂画面”的程度,而是观众的生理感知机制。面对一张静态照片,人类大脑在前一两分钟内就能穷尽所有符号学与叙事线索的读取;到了第 3 分钟以后,语义解码彻底停摆,眼睛会因为失去运动刺激而产生视觉疲劳、微颤(micro-saccades)和残影,胶片颗粒或屏幕像素的物理噪点开始在视网膜上“蠕动”。此时,照片不再是承载信息的容器,而变成了一面逼迫观众直面“时间流逝本身”的镜子。加拿大结构主义电影人迈克尔·斯诺(Michael Snow)在 1969 年的《蒙特利尔的一秒》(One Second in Montreal)里就做过极其接近的纯静帧实验:全片无声,仅由一连串静止照片组成,且每张照片的停留时长被拉扯到令人焦躁的程度——当画面静止突破某个时间阈值,观众对“拍了什么”的兴趣会彻底死去,转而进入一种近乎催眠或生理煎熬的纯粹时间体验。
但问题恰恰出在你的第二个条件上:“6 张图能构成一个故事”。
仅靠 6 张静态图像建立“故事”,高度依赖库里肖夫效应(Kuleshov Effect)——即观众在“切换(Cut)”发生的瞬间,用脑补去缝合画面 A 与画面 B 之间的因果逻辑(例如克里斯·马克的《堤》,正是通过精密控制静帧切换的节奏,才在静止中榨出了强烈的叙事张力)。然而,库里肖夫效应极度依赖大脑的短期工作记忆。当你把画面 A 死死按住整整 10 分钟,长达十分钟的凝视耗竭与感官钝化,早就把前一张画面积累的叙事势能彻底蒸发干净了。等到第 10 分钟剪辑点终于到来、画面切入 B 时,观众脑子里不会产生“哦,剧情推进到了下一步”的叙事连贯感,而只会遭受一次纯生理层面的惊吓——因为死寂了十分钟的银幕突然动了一下。
换句话说,在这套 60 分钟的装置里,“10 分钟的静置”和“6 张图讲故事”只能活下来一个:要么 6 张图之间的戏剧因果足够强,强到 10 分钟的等待变成了一种刻意拖延剧透的冗余折磨;要么 10 分钟的绝对静止真正击穿了观众的日常感知惯性,把人带入冥想或幻觉,而原本预设的那个“故事”,早在第 4 分钟就已经在纯粹的时间洪流里解体了。
10分钟也只是我为了拉开对比胡编的一个极端的数字。但是既然是实验也不能以看的舒服为目的,既然4分钟是极限,那就4分钟吧
👤
🤖
4 分钟是一个极具历史巧合的刻度——安迪·沃霍尔(Andy Warhol)的《试镜》(Screen Tests)系列,一卷 100 英尺的 16 毫米胶片降格以 16 帧/秒放映,物理时长恰好就是 4 分钟左右。
在沃霍尔的 4 分钟里,摄影机纹丝不动,被拍摄者被要求直视镜头且尽量不眨眼。观众之所以能扛过这 4 分钟的生理焦躁,是因为画面内部存在着“潜在事件(Potentiality)”——眼皮的微颤、泪腺的湿润、光线在皮肤上的微妙偏移。每一秒都蕴含着失控的可能,这种对“下一秒变化”的悬念死死拴住了视线。
但把同样的 4 分钟套在静态照片(Still Photograph)上,媒介的本体论就彻底变质了。照片是对过去某个 1/250 秒的绝对封存,画面内部没有任何物理时间在流动,变化发生的概率严格为零。观众在第 3 秒确认这是一张死照片后,悬念契约就宣告破裂。此时,强行维持 4 分钟的静默,不再是“不以舒服为目的的电影实验”,而是退化成了一种画廊刑罚——它本质上等价于把你按在美术馆的一幅画前,强行剥夺你的视线转移权,规定必须盯满 240 秒才准迈步走向下一幅。
即便卡在记忆衰退的临界点前(第 4 分钟)切入下一张图,这 6 张图构成的也依然不是“电影”,而是被锁定了翻页键的幻灯片放映。克里斯·马克的《堤》用静帧拍出了电影感,靠的是高密度剪辑制造出的心理运动;詹姆斯·班宁(James Benning)的《十三湖》每个镜头静态凝视几分钟却依然是纯粹的电影,靠的是风吹过湖面时帧内真实流逝的物理时间。唯独“死照片 + 4 分钟静置”卡在了一个尴尬的真空地带:它既没有电影的内部时间,又粗暴没收了摄影画册原本赋予读者的凝视自主权。
这也恰恰暴露出许多“反舒适”实验艺术最隐蔽的权力陷阱:创作者往往以为制造观众的感官煎熬就是先锋,却忽略了当媒介本身停止产生任何新的物理增量时,单纯拉长秒表读数,本质上只是作者利用放映机制对观众生命时间进行的一次单方面征用。真正决定一幅静止画面能否撑起 4 分钟的,从来不是剪辑台上的时长设定,而是画框内部是否还活着某种不受作者控制的物理时间。
那只能2个方向更改了:
- 静帧配上符合主题的背景音乐呢?
2.按你说的静帧已经被判了死刑,那是不是只要改成镜头就可以了呢?固定镜头,只要胶盘在转即便是胶片的噪点闪烁或者画面中灰尘的浮动,阳光移动了1毫米就可以了?
👤
🤖
第一个方向(静帧 + 契合主题的 BGM)是一条死胡同,而且它恰恰复刻了你前面最反感的东西。
你之前排斥《一分钟一幅画面》的口播和《持花少女》的构图,本质上是因为厌恶创作者把“标准答案”和“廉价情绪”强行塞进观众脑子里。而在所有视听元素中,“契合主题的配乐”恰恰是情绪操控欲最强、最专制的符号。一旦给一张静止照片配上悲怆的大提琴或悬疑的氛围音,音乐立刻接管了时间轴,照片瞬间退化为音乐的歌词配图。观众不再去审视画面内部的肌理,而是顺着和弦的起伏被动接受情绪按摩——这在媒介形态上既不是实验电影,也不是摄影,而是加长版的网易云音乐动态封面或商业展厅的氛围装置。
第二个方向(固定镜头 + 胶片噪点/灰尘/1毫米光线位移)则真正跨过了摄影与电影的本体论边界。
哪怕画面里没有一个人影、没有任何戏剧动作,只要摄影机在运转,哪怕只是胶片颗粒的随机沸腾、空气中浮尘的布朗运动,或者窗棂光影在 4 分钟里挪动了 1 毫米,影像的物理属性就发生了质变:
- 从“已死的完成时”变为“敞开的进行时”
静态照片是一个封闭系统,快门闭合的那一刹那,画面里所有可能发生的事情都已经结束了,观众只能做符号解码。而一个 4 分钟的固定长镜头是一个敞开的物理现场,它重新引入了电影最核心的魅力——偶然性(Contingency)。观众的视觉机制会从“看懂这张图”切换为“巡视这片领地”:大脑会本能地捕捉那 1 毫米的光线偏移和随时可能闯入画框的飞虫。哪怕最终什么大事也没发生,这种“随时可能发生点什么”的微观张力,就已经足够把 4 分钟的时间撑起来了。
- 当参照物彻底消失,只剩噪点闪烁时
如果你把镜头里的具象景物也抽干,只留下胶片银盐颗粒的噪点闪烁,这就直接撞进了 1960 年代欧美结构主义/唯物主义电影(Structural/Materialist Film)的腹地。像托尼·康拉德(Tony Conrad)的《闪烁》(The Flicker)或彼得·库贝尔卡(Peter Kubelka)的《阿努尔夫·雷纳》,干脆连摄影机镜头都不用,直接用纯黑、纯白胶片格或纯粹的颗粒频闪轰炸视网膜——此时电影不再记录任何外部世界,胶片本身的物理材质和放映机的机械运转就是全部的剧情。
- 它甚至反过来救活了你设想的“6 镜叙事”
伊朗导演阿巴斯·基亚罗斯塔米生前最后一部遗作《24 帧》(24 Frames),做的就是几乎一模一样的实验:他挑选了 24 张自己拍摄的静态摄影作品,用数字技术为每张照片注入了长达 4 分半钟的极细微动态(飘落的雪花、微风吹动的树枝、光线的缓慢推移),全程无台词、无配乐。
这种做法之所以能让“6 个镜头讲一个故事”成立,是因为那 4 分钟看似无聊的浮尘与光影位移,在银幕上积累出了极高的时间密度与物理重量。前一个镜头用 4 分钟向观众证明了这个空间的真实存在,等到第 4 分钟结束、画面突然切入下一个空间(比如同一扇窗前,光线已经变暗,或者桌上的杯子少了一只)时,每一次剪辑都会产生一种近乎地质变迁般的冷峻冲击力——此时的故事不再靠台词或表情推进,而是直接由“被看见的时间本身”来推动。
所以实验不用做了啊,
结论已经出来了:《一分钟一个画面》静帧画面不能称之为电影。
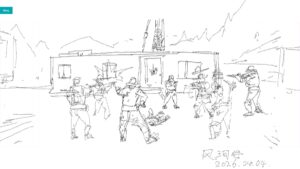
(但引出了一个问题:那初稿的分镜稿算不算电影啊?它倒是吻合部分我们说的实验的一部分,一个镜头一个静帧无论持续多长,只分了镜,但是完成了文本故事到视觉画面转换,这怎么解释呢)
👤
🤖
把初稿分镜稿和《一分钟一幅画面》并置,恰好踩中了电影理论里最隐蔽的一道裂缝:“视觉叙事(Visual Storytelling)”并不等于“电影(Cinema)”。
仅从“用静帧完成分镜切分、把文本故事转化为视觉画面”这几个条件来看,初稿分镜稿不仅不是电影,它在媒介本体上甚至完全等同于漫画(Sequential Art)。
漫画理论家斯科特·麦克劳德(Scott McCloud)对漫画的定义是“刻意排列的并置图像序列”。在初稿分镜里,时间是被空间化的——观众(或主创)通过视线从 A 格跳向 B 格,依靠两格之间的“格间空白(Gutter)”在脑内自行脑补出动作的延续与因果。无论你在分镜纸旁边标注了“持续 3 秒”还是“持续 10 分钟”,只要它停留在纸面或静态画板上,画面内部就没有物理时间在流逝,它就依然属于平面视觉语法的范畴。
分镜稿与《一分钟一幅画面》的根本区别,不在于画面动不动,而在于契约属性(Ontological Status):
- 《一分钟一幅画面》是封闭的消费终端:它把单张照片当成最终成品端上餐桌,强迫观众在 60 秒的死时间里对着一张不再产生任何增量的图像进行审美消费,这属于媒介错位。
- 初稿分镜稿是未完成的生产指令:分镜本质上是一张工业施工图,每一帧草图都是一个“占位符(Placeholder)”。画框里的透视线、粗犷的动态线(Action lines)、甚至标注镜头运动的箭头,本质上都是对未来摄影机调度、焦段景深和物理时间的一张“期票”。
哪怕更进一步,把初稿分镜按精确的帧数(Timing)剪辑成动态分镜(Animatic / Story Reel)并配上临时音效,让每一张静帧严格按照电影的时间轴自动跳动,它依然只是“电影的模拟器”——它的存在目的是在烧掉昂贵的实拍或三维渲染预算之前,对叙事节奏、视听信息和剪辑语法做一次低成本的压力测试。
但这个命题最反直觉的悖论恰恰藏在这里:如果套用电影史上另一派的理论,初稿分镜稿不仅算电影,甚至已经完成了电影最核心的 80%。
电影史在本体论上一直分裂为两派。一派是以巴赞、塔可夫斯基为代表的“摄影机现实主义/时间派”,他们认为电影的本质是记录物理世界在时间中的真实绵延(风吹草动、光影推移),没有这段真实流逝的物理时间,分镜稿就永远只是草图;而另一派是以爱森斯坦、希区柯克为代表的“蒙太奇/设计派”。希区柯克曾多次公开宣称,对他而言,电影在画完分镜的那一刻就已经彻底拍完了,后续进棚开机拍摄不过是极其无聊的体力劳动和机械执行。
在这个意义上,初稿分镜稿其实是“纯粹去除了物理肉身的电影骨架”。
更讽刺的是,在真实的视觉工业生产中,往往会出现一种诡异的退化现象:初稿分镜(尤其是动态分镜阶段)凭借极简的笔触、留白的阴影和极具攻击性的剪辑节奏,常常展现出极强的视觉势能与电影感;可一旦进入后续的清稿、精细建模、标准布光与机械渲染,无数“正确的工业细节”反而把原本草图里那种凌厉的运动幻觉给填死了。这正是分镜稿最危险的魅惑之处——它以未完成态的形态,提前透支并锁定了电影的灵魂,却把最沉重的物理时间肉身留给了后面的工序去苦苦追赶。
最后这段,只要经历过国产3D动画的番剧就能体会。建模、场景、动补、灯光都是在你意料之外的扣分项。
说到这就得膜拜一下《灵笼》的分镜师和3维团队。顶级
👤
🤖
国产3D番剧在下游工序出现集体性的“预期外扣分”,本质上是高度割裂的工业流水线对作者视听语法的逐层稀释。
初稿分镜与动态预演(Animatic)之所以具备极强的戏剧张力,是因为创作者在二维平面上天然依赖透视夸张、剪影压缩与大面积的黑白负空间来强制锁定观众视线。然而,一旦这套草图进入标准化的3D制作管线,下游各环节往往不再服务于“单镜头戏剧势能”,而是转向各自孤立的技术指标考核:
- 模型与材质的“细节过载”:资产部门为了证明制作精度,会在角色皮肤纹理、衣物褶皱和场景道具上堆砌高精度的 PBR 材质。当所有局部都在争夺视觉注意力时,原本分镜里靠留白建立的主次层级瞬间坍塌,画面陷入一种“处处清晰、处处平庸”的视觉噪音。
- 动补(Mocap)的自然主义陷阱:动作捕捉记录的是真人演员在日常重力下的物理惯性与细微抖动,这种信息在实拍电影中是“真实感”,但套在风格化比例的3D角色模型上,如果不经过高强度的手K修型(Keyframe Cleanup)注入预备动作(Anticipation)与过冲(Overshoot),就会呈现出一种诡异的失重感与“皮套人”式的舞台腔。
- 灯光环节的“照明思维”:多数番剧的灯光停留在“把昂贵的模型照亮让观众看清”的阶段,滥用均匀的全局光照(GI)填平暗部,直接抹杀了分镜阶段赖以制造悬念的阴影块面。
《灵笼》之所以能逃脱这种“越往后做越平庸”的工业诅咒,核心不在于单点环节的预算堆砌,而在于它用电影摄影机逻辑重新统合了 Pre-vis(视觉预演)到最终渲染的整条管线。
在镜头调度上,《灵笼》摒弃了3D动画最廉价的“无重力贝塞尔曲线推拉”,严格模拟物理摄影机的光学限制——大量使用长焦空间压缩、前景遮挡(Dirty Frame)、手持呼吸感微颤以及果断的焦点转移(Rack Focus),强行把三维空间重新压回分镜预设的视觉焦点上。在动作层面,其团队对动补数据进行了极高比例的二次关键帧重塑,尤其是重型机甲(重力体)的重量感分配与面部微表情绑定,彻底规避了国产3D常见的“面瘫与滑步”。
更关键的是它的减法布光:《灵笼》敢于把耗费巨资建好的场景细节藏进深邃的死黑阴影里,仅靠高反差的轮廓光(Rim Light)、体积雾与局部定向光束去雕刻人物轮廓。这种布光策略实际上是把初稿分镜里那种粗粝、锐利的炭笔阴影,直接在三维渲染器里进行了物理还原。
不过,《灵笼》这种高度依赖核心主创审美意志、强行扭转工业惯性的模式,本质上是一种反流水线的“作坊式重工业”。当整个行业被平台资本推向高周转的“年番化”生产,或是全面转向虚幻引擎(UE)实时渲染管线时,如何在追求出片吞吐量的同时,防止标准化资产库与自动化全局光照再次把导演的镜头语言“熨平”,依然是当下3D动画工业最难跨越的断层。
📅 对话导出时间: | ✨ Powered by Google Gemini AI | 🔄 由 Gemini WP Publisher V4 自动发布
发表回复